Préparer des textes comparables
Le projet part d’une question d’attribution : lequel de Baudelaire, Hugo ou Rimbaud a écrit ce poème ? Dans le cadre du cours de NLP à l’ESIEA, j’ai travaillé sur un corpus de 208 poèmes provenant de pages du Projet Gutenberg.
La préparation transforme des textes édités différemment en entrées comparables. Elle sépare les poèmes des éléments périphériques, normalise le texte et conserve les données préparées en JSON. Ce travail en amont évite de refaire l’analyse linguistique à chaque expérience et permet aux modèles de recevoir les mêmes entrées.
Passer des segments au poème entier
Les textes sont découpés en fenêtres, puis traités avec spaCy avant leur conversion en indices. Le vocabulaire est construit à partir de l’apprentissage. Les segments restent groupés par poème lors de la séparation des ensembles : 145 poèmes pour apprendre, 31 pour valider et 32 pour tester.
J’ai comparé un MLP, un RNN, un LSTM et un GRU avec TensorFlow/Keras. Chaque modèle produit des probabilités par segment ; leur moyenne donne la décision pour le poème complet. Cette agrégation relie les unités utilisées pendant l’apprentissage à la question réellement posée au lecteur.
Examiner les résultats et les erreurs
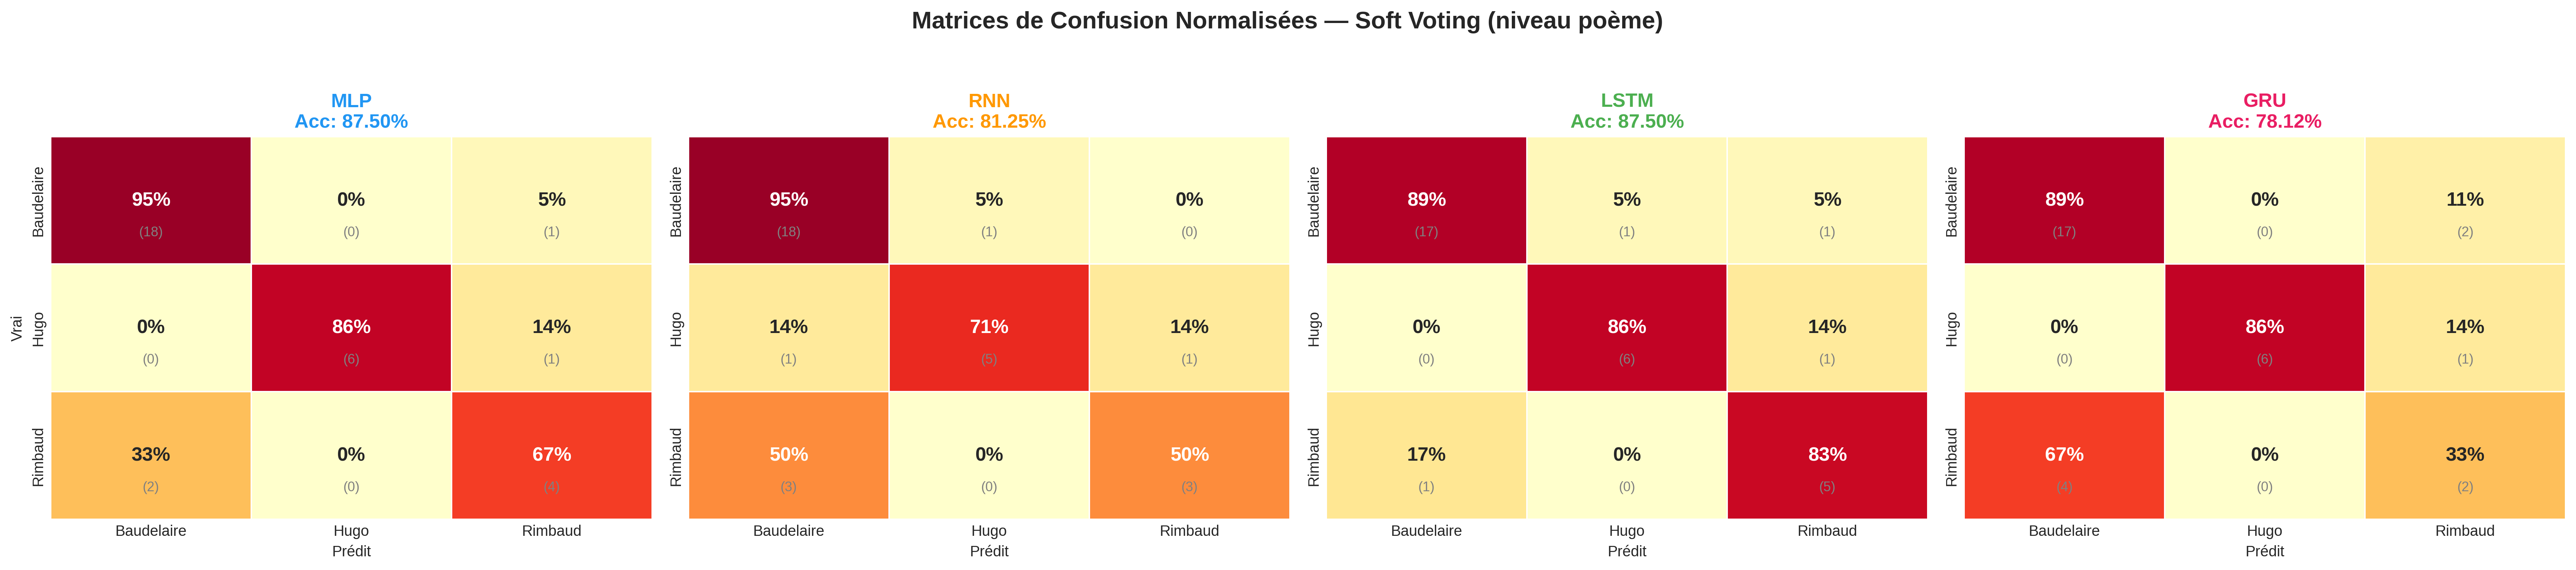
Le rapport final donne 87,5 % de bonnes attributions au MLP et au LSTM sur les 32 poèmes de test, contre 81,25 % pour le RNN et 78,12 % pour le GRU. Le MLP atteint donc la même exactitude que le LSTM avec moins de paramètres dans cette expérience.
J’ai également étudié les matrices de confusion et les métriques par auteur. Elles complètent le score global, notamment sur un corpus où Baudelaire est davantage représenté. Le jeu de test intervient dans la sélection des checkpoints documentée ; ces résultats décrivent cette expérience, sans constituer une évaluation finale indépendante.
Faire évoluer les modèles à partir des observations
Les écarts entre apprentissage et validation ont guidé mes essais sur la capacité, la régularisation et les paramètres d’apprentissage. Les notebooks Jupyter conservent les courbes et les commentaires nécessaires pour rapprocher un changement de son résultat, sans attribuer un effet isolé à chaque réglage modifié ensemble.
Un second volet compare la génération en caractères et en mots. Il prolonge le travail sur les représentations du texte, avec son propre protocole. La contribution centrale reste la construction d’une comparaison lisible, depuis les données jusqu’à l’interprétation des sorties.